Nach ein paar Tagen, die wirklich danach aussahen, als wäre der Winter vorbei, sah „meine“ Badestelle gestern wieder aus wie im tiefsten Winter …
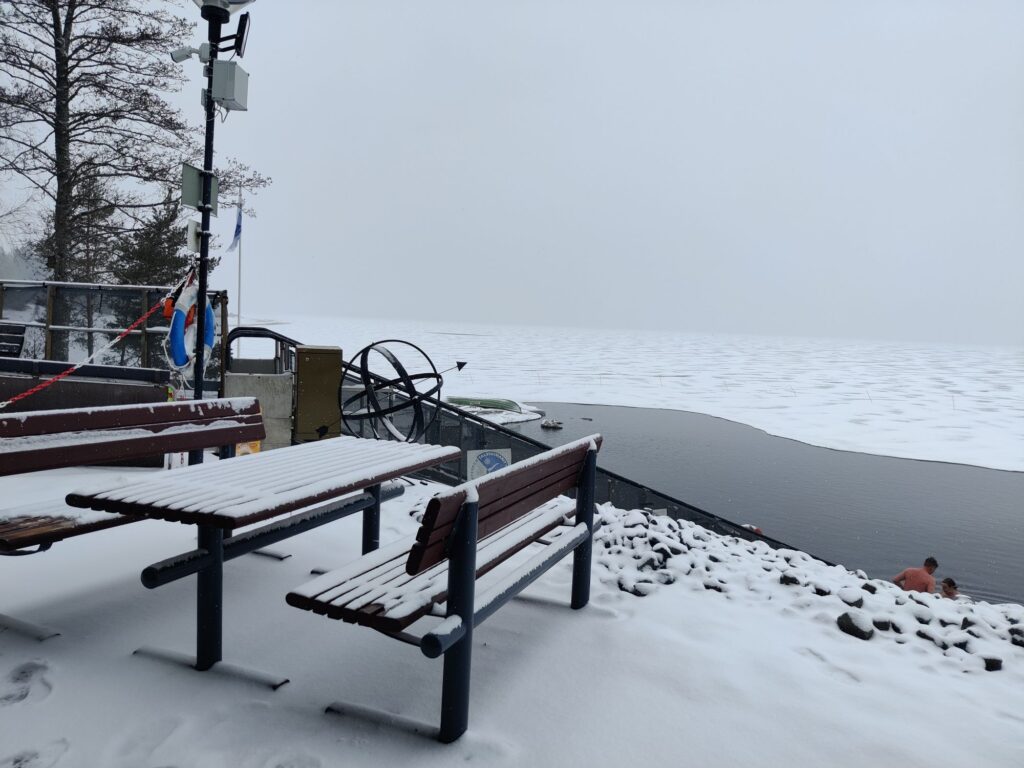
Nach ein paar Tagen, die wirklich danach aussahen, als wäre der Winter vorbei, sah „meine“ Badestelle gestern wieder aus wie im tiefsten Winter …
Unser R-Paket Fluidigm ist gerade auf CRAN erschienen. Es soll die Analyse von Genotypisierungsdaten aus Fluidigm-Geräten vereinfachen und bietet eine Reihe von Werkzeugen für Datenaufbereitung und Analyse, die Forschenden die Arbeit mit ihren Daten erleichtern. Das sind die wichtigsten Funktionen des Pakets:
fluidigm2PLINK(...): Wandelt Fluidigm-Daten in das Format von PLINK um und erzeugt aus der CSV-Ausgabe des Fluidigm-Geräts ein ped/map-Dateipaar.estimateErrors(...): Schätzt Fehler in den Genotypisierungsdaten.calculatePairwiseSimilarities(...): Berechnet paarweise Ähnlichkeiten zwischen Proben.getPairwiseSimilarityLoci(...): Ermittelt die Loci der paarweisen Ähnlichkeit.similarityMatrix(...): Erzeugt eine Ähnlichkeitsmatrix.Man kann diese Funktionen einzeln ausführen oder alle auf einmal mit der praktischen Hüllfunktion fluidigmAnalysisWrapper(...).
In der Genomik muss man oft die nächstgelegenen Varianten (z. B. SNPs, Indels) zu einer Reihe interessanter Genomorte finden. Das geht mit verschiedenen Bioinformatik-Werkzeugen wie bedtools. In diesem Beitrag zeige ich Schritt für Schritt, wie das funktioniert.
Bevor es losgeht, sollten folgende Dateien vorhanden sein:
locations_of_interest.bedFinalSetVariants_referenceGenome.vcfDas erste Problem war, dass die VCF-Datei nicht lexikografisch sortiert war. bedtools verlangt aber genau diese Sortierung. Die VCF-Datei lässt sich mit folgendem Befehl sortieren:
(grep '^#' FinalSetVariants_referenceGenome.vcf; grep -v '^#' FinalSetVariants_referenceGenome.vcf | sort -k1,1 -k2,2n) > sorted_FinalSetVariants_referenceGenome.vcf
Der Befehl trennt die Kopfzeilen (die mit # beginnen) von den Datenzeilen, sortiert die Datenzeilen und fügt Kopf und sortierte Daten in einer neuen Datei sorted_FinalSetVariants_referenceGenome.vcf zusammen.
Als Nächstes suchen wir die nächstgelegenen Varianten zu unseren Orten. Standardmäßig gibt bedtools closest aber den ganzen VCF-Eintrag aus, was oft mehr ist als nötig. Um die Ausgabe zu begrenzen, wandeln wir die VCF-Datei unterwegs ins BED-Format um und vergeben als zusätzliches Merkmal den Markernamen als chr_bpLocation (so benennen wir unsere Marker). Mit der Option -d bekommen wir außerdem den Abstand zwischen dem Ort und der nächsten Variante. Hier der Befehl:
awk 'BEGIN {OFS="\t"} {if (!/^#/) {print $1,$2-1,$2,$4"/"$5,"+",$1"_"$2}}' sorted_FinalSetVariants_referenceGenome.vcf | bedtools closest -a locations_of_interest.bed -b stdin -d
Der Befehl liest mit awk die VCF-Daten, wandelt sie ins BED-Format um und schreibt das Ergebnis auf die Standardausgabe. Die Pipe (|) gibt diese Ausgabe direkt als -b-Datei an bedtools closest weiter. Das Schlüsselwort stdin sagt bedtools, dass es von der Standardeingabe lesen soll.
Mit diesen zwei Schritten findet man effizient die nächstgelegenen Varianten zu einer Reihe interessanter Genomorte. Der Ansatz ist flexibel und lässt sich an andere Datensätze und Anforderungen anpassen.
Hast du dich schon einmal gefragt, wie die Zellen im Kuheuter auf eine bakterielle Infektion reagieren? In unserer neuesten Studie haben wir mit einer neuen Methode die Genexpression primärer boviner Milchdrüsen-Epithelzellen (pbMECs) nach Kontakt mit Escherichia coli untersucht, einem häufigen Auslöser von Mastitis bei Milchkühen. Mastitis ist eine teure und schmerzhafte Krankheit, die sowohl das Tierwohl als auch die Milchleistung beeinträchtigt. Wenn wir die molekularen Mechanismen der Immunantwort verstehen, finden wir hoffentlich neue Wege, Mastitis vorzubeugen und zu behandeln und Kühe zu züchten, die widerstandsfähiger gegen Infektionen sind.
Wir haben pbMECs aus frischen Milchproben gewonnen und im Labor kultiviert. Dann haben wir sie hitzeinaktivierten E. coli ausgesetzt und die Veränderungen der Genexpression 3 und 24 Stunden danach per RNA-Sequenzierung gemessen. Der Kontakt mit E. coli löste eine starke Entzündungsreaktion in den pbMECs aus, an der Gene und Signalwege der Zytokin-Signalübertragung, der Toll-like-Rezeptoren und der Antigenpräsentation beteiligt waren. Außerdem haben wir einige neue Kandidatengene gefunden, die bisher nicht mit Mastitis bei Rindern in Verbindung gebracht wurden.
Unsere Studie zeigt, dass aus Milch gewonnene pbMECs als nicht invasives In-vitro-Modell dienen können, um Mastitisresistenz bei Rindern zu untersuchen. Gegenüber herkömmlichen Methoden hat das mehrere Vorteile: kein Tierleid, geringere Kosten und die Möglichkeit von Hochdurchsatz-Screenings. Unsere Ergebnisse liefern neue Einblicke in die molekularen Grundlagen der Immunantwort im Euter und zeigen mögliche Ansatzpunkte für künftige Maßnahmen. Mehr dazu im vollständigen Artikel: Iso-Touru et al. Veterinary Research (2024) 55:13.
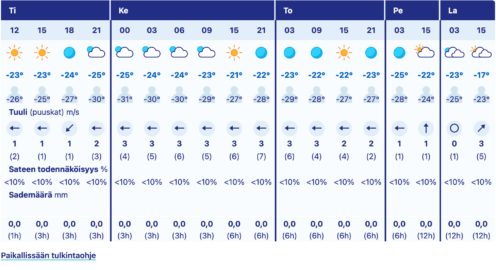
Das neue Jahr beginnt hier in Finnland bitterkalt; die nächsten 4–5 Tage haben wir um die -25 Grad Celsius, da müssen die Kamine also richtig ran …