Heute Morgen hatte ich, glaube ich, eine ziemlich gute Ausrede, auf meinen inneren Schweinehund zu hören und das Laufen ausfallen zu lassen. Bei uns ist es gerade ziemlich kalt.
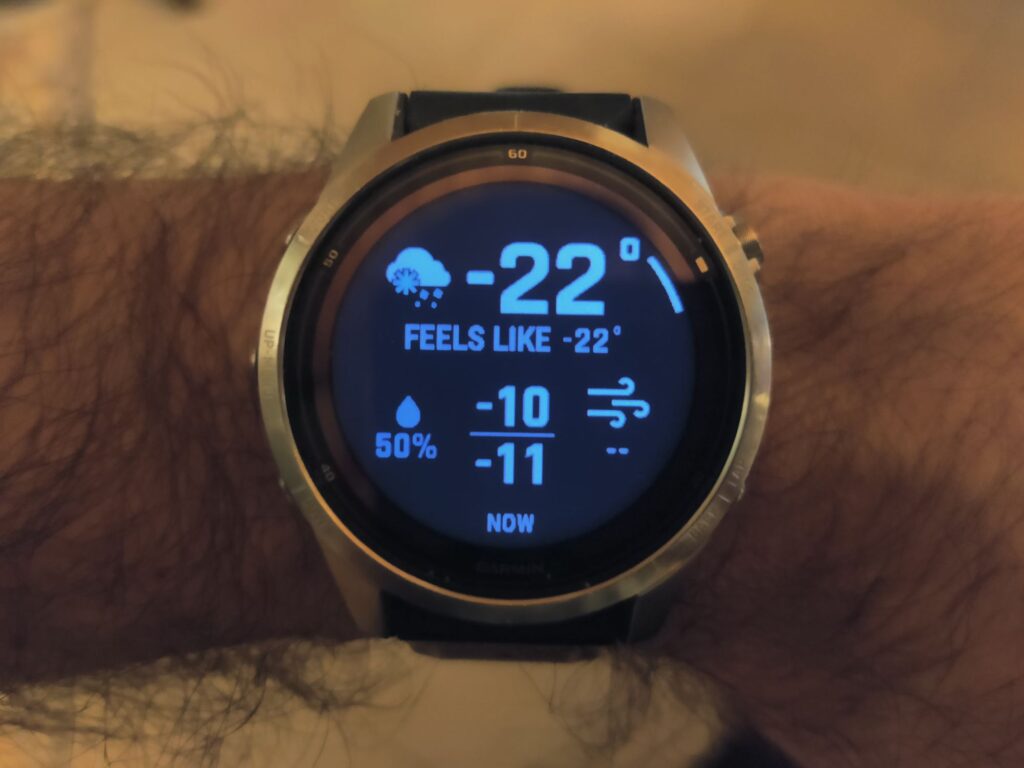
Heute Morgen hatte ich, glaube ich, eine ziemlich gute Ausrede, auf meinen inneren Schweinehund zu hören und das Laufen ausfallen zu lassen. Bei uns ist es gerade ziemlich kalt.
Ein Jahr mit recht gemischten Gefühlen, 2025 ist vorbei. Aus meiner Sicht gab es viele Höhen und Tiefen, und ein wenig fürchte ich, dass es 2026 ähnlich wird; es könnte also eine holprige Fahrt werden. Mal sehen, was kommt. Trotzdem alles Gute für das neue Jahr!
Das Jahr hat bei uns ziemlich kalt angefangen, in der Silvesternacht hatten wir etwa -14 Grad.
Bei rechenintensiven Workflows mit Snakemake kann es passieren, dass zu viele Jobs parallel laufen und übermäßige I/O-Last, Speicherdruck oder hohe Latenz auf der Festplatte verursachen. Das kann zu fehlgeschlagenen Jobs oder schlechter Leistung führen.
Snakemake bietet mit der Direktive resources eine Möglichkeit, die parallele Ausführung pro Regel zu begrenzen; das funktioniert aber nur, wenn man beim Ausführen des Workflows auch ein globales Ressourcenlimit angibt.
In diesem Beitrag zeige ich, wie man die Zahl paralleler Jobs für eine bestimmte Regel mit dem Ressourcenmanagement von Snakemake richtig begrenzt.
Nehmen wir folgende Snakemake-Regel:
rule process_data:
    input:
        "{sample}.raw"
    output:
        "{sample}.processed"
    resources:
        process_data_jobs=1  # Assign a resource unit for limiting the number of jobs
    shell:
        """
        some_tool --input {input} --output {output}
        """
resources allein die Ausführung nicht?Man könnte erwarten, dass resources: processing_jobs=1 Snakemake automatisch auf einen Job gleichzeitig beschränkt. Snakemake plant aber nicht nach Ressourcen, solange man beim Start des Workflows kein globales Limit angibt.
Ohne globales Limit startet Snakemake womöglich trotzdem zu viele Jobs parallel und überlastet das System.
Um die Zahl paralleler Jobs tatsächlich zu begrenzen, startet man Snakemake mit:
snakemake --resources process_data_jobs=10
process_data fordert 1 Einheit von process_data_jobs an.processing_jobs=10 sorgt dafür, dass höchstens 10 Jobs (10 / 1 = 10) parallel laufen. Man kann auch andere Einheiten wählen, wenn man möchteVor dem Limit liefen teils viel zu viele Jobs gleichzeitig! Danach durften nur noch 10 Jobs parallel laufen.
Wer in Snakemake mit hoher Festplattenlatenz, I/O-Druck oder zu vielen gleichzeitigen Jobs kämpft, bekommt das am besten in den Griff, indem er:
resources die Ressourcen pro Job festlegt.--resources processing_jobs=10).So läuft der Workflow effizient und zuverlässig, ohne das System zu überlasten!
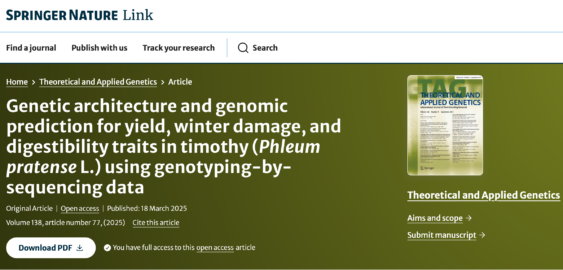
Wiesen-Lieschgras (Phleum pratense L.) ist ein wichtiges Futtergras für die finnische Landwirtschaft, und Ertrag, Winterhärte und Verdaulichkeit zu verbessern ist entscheidend für eine nachhaltige Produktion. In unserer aktuellen Studie haben wir untersucht, wie sich der Zuchtfortschritt mit genomischer Vorhersage beschleunigen lässt, gestützt auf Genotyping-by-Sequencing und fortgeschrittene statistische Modelle.
Wichtigste Ergebnisse:
* Die geschätzten Heritabilitäten reichten von 0,13 (Ertrag beim ersten Schnitt) bis 0,86 (Verdaulichkeit beim zweiten Schnitt).
* Genetische Korrelationen deuten auf einen Zielkonflikt zwischen Ertrag und Überwinterung hin, aber auf positive Zusammenhänge zwischen den Verdaulichkeitsmerkmalen.
* Genomische Zuchtwerte wurden mit fortgeschrittenen statistischen Verfahren geschätzt, darunter eine neue Skalierung der genomischen Verwandtschaftsmatrix.
* Die Vorhersagegenauigkeit erreichte bis zu 0,62 für die Verdaulichkeit, und die Validierung bestätigte eine mittlere Genauigkeit bei geringer Streuung.
Trotz der Sorge, dass die Genotypqualität die Vorhersagen beeinträchtigen könnte, zeigen unsere Ergebnisse, dass genomische Vorhersage ein starkes Werkzeug für die Lieschgraszüchtung in Finnland bleibt. Die Arbeit zeigt, wie datengetriebene Zuchtstrategien Widerstandsfähigkeit und Qualität von Futterpflanzen verbessern können.
https://link.springer.com/article/10.1007/s00122-025-04860-9
Ich habe gerade ein neues R-Paket namens „SnakebiteTools“ begonnen. Dort möchte ich kleine Hilfsfunktionen sammeln, um Snakemake-Läufe besser zu analysieren und zu überwachen. Die Ausgabe lässt sich später zur Ressourcenoptimierung nutzen, um den Stand eines laufenden Snakemake-Laufs zu prüfen (was bei Läufen mit sehr vielen Jobs unübersichtlich werden kann) usw.