Ich habe gerade ein neues R-Paket namens „SnakebiteTools“ begonnen. Dort möchte ich kleine Hilfsfunktionen sammeln, um Snakemake-Läufe besser zu analysieren und zu überwachen. Die Ausgabe lässt sich später zur Ressourcenoptimierung nutzen, um den Stand eines laufenden Snakemake-Laufs zu prüfen (was bei Läufen mit sehr vielen Jobs unübersichtlich werden kann) usw.
Kategorie: R
-
Das R-Paket Fluidigm
Unser R-Paket Fluidigm ist gerade auf CRAN erschienen. Es soll die Analyse von Genotypisierungsdaten aus Fluidigm-Geräten vereinfachen und bietet eine Reihe von Werkzeugen für Datenaufbereitung und Analyse, die Forschenden die Arbeit mit ihren Daten erleichtern. Das sind die wichtigsten Funktionen des Pakets:
fluidigm2PLINK(...): Wandelt Fluidigm-Daten in das Format von PLINK um und erzeugt aus der CSV-Ausgabe des Fluidigm-Geräts ein ped/map-Dateipaar.estimateErrors(...): Schätzt Fehler in den Genotypisierungsdaten.calculatePairwiseSimilarities(...): Berechnet paarweise Ähnlichkeiten zwischen Proben.getPairwiseSimilarityLoci(...): Ermittelt die Loci der paarweisen Ähnlichkeit.similarityMatrix(...): Erzeugt eine Ähnlichkeitsmatrix.
Man kann diese Funktionen einzeln ausführen oder alle auf einmal mit der praktischen Hüllfunktion
fluidigmAnalysisWrapper(...). -
Urlaubslektüre ist da
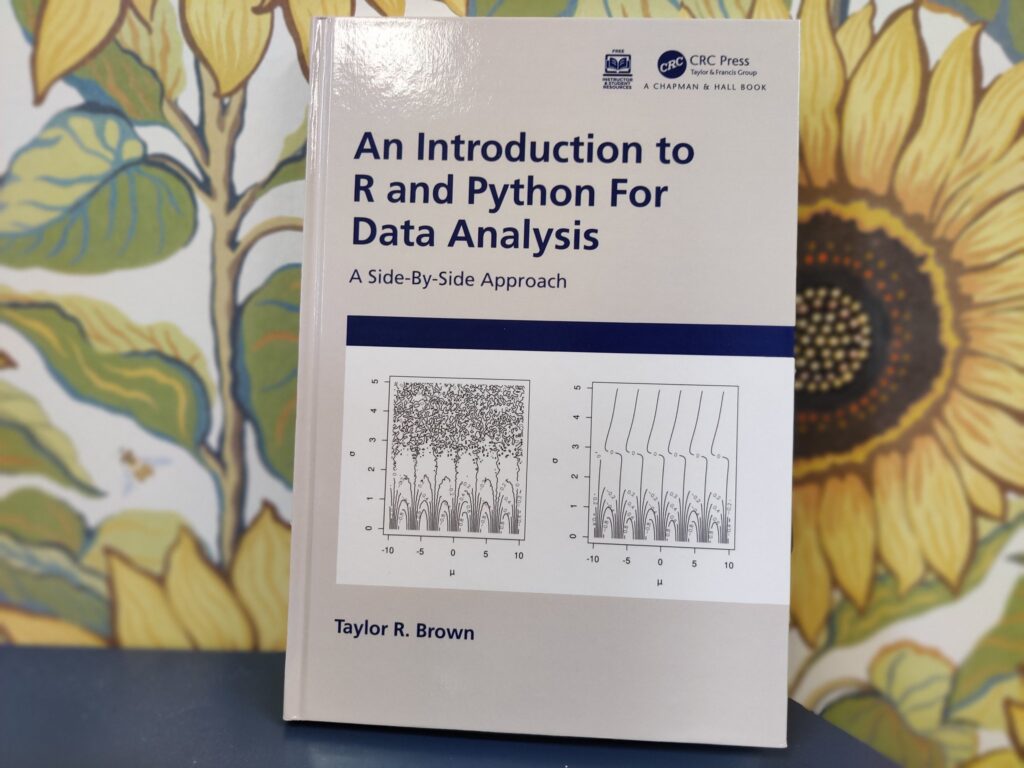
Pünktlich zu den anstehenden Herbstferien ist meine Herbstferien-Lektüre angekommen! Ich freue mich auf etwas leichte Lektüre; mein Python ist in letzter Zeit etwas eingerostet, da ist es ein schöner Neustart, mal wieder aus Einsteigersicht darüber zu lesen. Der erste Eindruck ist richtig gut!
-
Gewichtete Tabellen mit R / Summe numerischer Werte je Kategorie
Der normale Tabellenbefehl
table()berechnet die Häufigkeit jedes Elements eines Vektors, etwa so:R> df <- data.frame(var = c("A", "A", "B", "B", "C", "C", "C")) R> table(df) df A B C 2 2 3Er sagt uns also, dass wir zweimal A und B und dreimal C haben.
Haben wir aber eine Situation wie diese:
df <- data.frame(var = c("A", "A", "B", "B", "C", "C", "C"), value = c(10, 20, 20, 40, 15, 25, 35))also eine kategoriale Variable
varund eine numerische Variablevalue, und wollen für jede Kategorie die Summe über die numerische Variable, dann nehmen wir einfach den Base-R-Befehlaggregate, etwa soR> aggregate(value ~ var, data = df, FUN = sum) var wt 1 A 40 2 B 60 3 C 70Da ich auch oft das Paket
data.tablenutze, hier noch eine einfache Lösung damit; angenommen, wir machen (bzw. haben eine Datentabelle aus einer anderen Quelle, etwafread)library("data.table") dt <- data.table(df)Dann können wir einfach über eine Spalte in Abhängigkeit von einer anderen summieren, etwa so (und den Wert einer neuen Variablen
totzuweisen):setDT(dt)[, .(n = sum(value)), var] -
Eine fehlgeschlagene R-Paket-Installation ließ sich nicht löschen
Heute ist mir etwas Seltsames passiert, als ich ein Update für eines meiner R-Pakete installieren wollte. Wie üblich habe ich die neueste Version so installiert
library("devtools")
install_github("fischuu/GenomicTools")
Die Installation schlug aber fehl, und als ich sie wiederholen wollte, kam diese Fehlermeldung:
Installing package into ‘/homeappl/home/<user>/R/x86_64-redhat-linux-gnu-library/4.1’
(as ‘lib’ is unspecified)
ERROR: failed to lock directory ‘/homeappl/home/<user>/R/x86_64-redhat-linux-gnu-library/4.1’ for modifying
Try removing ‘/homeappl/home/<user>/R/x86_64-redhat-linux-gnu-library/4.1/00LOCK-GenomicTools’
Warning message:
In i.p(...) :
  installation of package ‘/tmp/Rtmp<...>Lv/file3c36<...>34/GenomicTools_0.2.11.tar.gz’ had non-zero exit status
Also bin ich in das genannte Verzeichnis gegangen, um den Ordner von Hand zu löschen, und bekam dort einen weiteren Fehler:
rm: cannot remove '00LOCK-GenomicTools/GenomicTools/libs/.nfs00000001002e2<...>d': Device or resource busyIch habe dies und das versucht, aber nichts half, den Ordner zu löschen; er meldete mir hartnäckig, dass das Gerät beschäftigt sei. Am Ende half nur, den Ordner umzubenennen, etwa so
mv 00LOCK-GenomicTools/ 00LOCK-GenomicTools-deleteThis/Er hängt jetzt immer noch im Ordner herum, aber ich konnte das R-Paket neu installieren. In ein paar Tagen schaue ich wieder nach, ob das Gerät noch beschäftigt ist oder ob ich ihn dann löschen kann …
