Kategorie: Wissenschaft

  • Neue Publikation

    Neue Publikation

    Unsere Publikation „Validated quantitative trait loci for eggshell quality in experimental and commercial laying hens“ ist als Kurzmitteilung in Animal Genetics erschienen.

    Zusammenfassung

    Eine schlechte Eischalenqualität verursacht der Eierwirtschaft erhebliche wirtschaftliche Verluste. Die Zucht auf bessere Eischalenqualität ist sehr schwierig. Eischalenqualität ist ein Merkmal, das stark von markergestützter Selektion profitieren würde: Damit ließen sich Hähne nach ihrem direkten Beitrag zum Merkmal auswählen, und man könnte Messungen einbeziehen, die mehrere schwer messbare Schalenparameter zusammenfassen. In dieser Studie haben wir die vielversprechendsten autosomalen Quantitative Trait Loci (QTL) für Eischalenqualität auf den Chromosomen 2, 3, 6 und 14 aus früheren Experimenten ausgewählt und die F2-Population auf 1599 F2-Hennen erweitert. Die Studie wurde an zwei kommerziellen Populationen wiederholt: einer Rhode-Island-Red-Linie von Lohmann Tierzucht (n = 692 Hennen) und einer White-Plymouth-Rock-Linie von Hy-Line (n = 290 nachkommengeprüfte Hähne). Wir haben die ausgewählten autosomalen QTL-Regionen in den drei Populationen mit SNP-Markern in einer Dichte von 4–13 SNPs/Mb analysiert. Die QTL für Eischalenqualität ließen sich in der F2-Population in allen untersuchten Regionen bestätigen. Neue QTL fanden wir für die Eischalenfarbe auf den Chromosomen 3 und 6. Marker-Assoziationen mit Merkmalen der Eischalenqualität wurden in den untersuchten kommerziellen Linien auf den Chromosomen 2, 3 und 6 bestätigt; das ebnet den Weg für markergestützte Selektion auf bessere Eischalenqualität.
  • Vergleich des neuen Rindergenoms

    Vergleich des neuen Rindergenoms

    Seit 2014 war das UMD-3.1-Genom der Standard für Genomstudien beim Rind, z. B. hier zum Herunterladen:


    Vor ein paar Tagen ist aber eine neue Assemblierung erschienen, ARS_UCD1.2. Sie lässt sich hier herunterladen:

    ftp://ftp.ncbi.nlm.nih.gov/genomes/all/GCA/002/263/795/GCA_002263795.2_ARS-UCD1.2/

    Um mir einen schnellen Eindruck zu verschaffen, habe ich beide Assemblierungen mit LAST http://last.cbrc.jp/ verglichen und auf Ähnlichkeit geprüft.

    Zuerst habe ich eine LAST-Datenbank angelegt, etwa so

    lastdb -P0 -uNEAR -R01 $FOLDER/UMD31/UMD31-NEAR $FOLDER/UMD31/UMD3.1_chromosomes.fa
    

    Dann habe ich die Substitutions- und Lückenhäufigkeiten bestimmt

    last-train -P0 --revsym --matsym --gapsym -E0.05 -C2 $FOLDER/UMD31/UMD31-NEAR $FOLDER/ARS/ARS_UCD12.fna > $FOLDER/UMD-ARS.mat
    

    Nach dem Training lief das Blasten (hier der parallele Teil des Slurm-Skripts)

    FOLDER="/wrk/daniel/References/";
    chr=($(ls $FOLDER/ARS/chr*));
    
    lastal -m50 -E0.05 -C2 -p $FOLDER/UMD-ARS.mat $FOLDER/UMD31/UMD31-NEAR ${chr[$SLURM_ARRAY_TASK_ID]} | last-split -m1 > UMD-ARS-$SLURM_ARRAY_TASK_ID.maf
    

    Da ich das Blasten für jedes Chromosom parallel laufen ließ, mussten die Kopfzeilen der Dateien entfernt werden

    cat *.maf > all.maf
    sed '/^#/ d' < all.maf > temp.maf
    head -n 22 all.maf > headerLines
    cat headerLines temp.maf > alignments.maf

    Zum Schluss wurden die zusammengeführten Simple-Sequence-Alignments verworfen, die Alignments ins Tabellenformat umgewandelt und Alignments mit einer Fehlerwahrscheinlichkeit > 10^-5 verworfen:

    last-postmask alignments.maf |
    maf-convert -n tab |
    awk -F'=' '$2 <= 1e-5' > alignments.tab

    Und aus dieser Tab-Datei wurde dann der Dotplot erstellt

    last-dotplot -x 4000 -y 4000 alignment.tab alignment.png

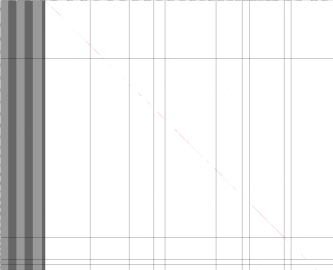
    So sieht der Dotplot aus: Es scheint im Großen und Ganzen dasselbe Genom zu sein, in manchen Bereichen hat es sich aber deutlich verändert! (Öffnen und an die Diagonale heranzoomen, um die Unterschiede zu sehen)


    Für die Schritte habe ich mich an diese Anleitung gehalten: https://github.com/mcfrith/last-genome-alignments


  • Tolles Buch über statistische Inferenz

    In den letzten Tagen bin ich auf ein wirklich schönes Buch gestoßen, das einen aktuellen Überblick bzw. eine Auffrischung zur statistischen Inferenz bietet: „Computer Age Statistical Inference: Algorithms, Evidence and Data Science“ von Bradley Efron und Trevor Hastie.

    Auf der Webseite von Trevor Hastie gibt es sogar einen Download-Link zum PDF des Buchs. Sehr zu empfehlen!

    https://web.stanford.edu/~hastie/CASI/

  • Neue Publikation

    Die Novemberausgabe von Computer Methods and Programs in Biomedicine
    enthält einen Artikel über mein R-Paket „GenomicTools“:

    http://www.sciencedirect.com/science/article/pii/S0169260716308549

    The R-package GenomicTools for multifactor dimensionality reduction and the analysis of (exploratory) Quantitative Trait Loci

    Hintergrund und Ziele

    Wir stellen das R-Paket GenomicTools vor, mit dem sich unter anderem eine Multifactor Dimensionality Reduction (MDR) zur Identifizierung von SNP-SNP-Interaktionen durchführen lässt. Das Paket bietet außerdem eine neue Klasse von Tests für eine (explorative) Quantitative-Trait-Loci-Analyse, die einige Schwächen anderer verbreiteter (e)QTL-Ansätze überwindet. Verbreitete (e)QTL-Ansätze mit linearen Modellen oder ANOVA beruhen oft auf zu stark vereinfachten Modellen mit schwachen statistischen Eigenschaften, die nicht robust gegenüber Ausreißern sind.

    Methode

    Der Algorithmus zur Berechnung der MDR ist etabliert. Um die Berechnung in R zu beschleunigen, haben wir ihn in C++ implementiert. Unsere Implementierung erlaubt außerdem, mehrere MDR-Ergebnisse zu einem MDR-Ensemble-Klassifikator zu kombinieren. Das (e)QTL-Testverfahren beruht auf einem verallgemeinerten Mann-Whitney-Test, der auf gerichtete Alternativen zugeschnitten ist, wie sie in einer (e)QTL-Analyse vorliegen.

    Ergebnisse

    Unser Paket GenomicTools bietet Funktionen, um die SNP-Kombinationen mit der höchsten Genauigkeit für ein MDR-Klassifikationsproblem zu bestimmen. Außerdem lassen sich die besten MDR-Ergebnisse zu einem gemeinsamen Ensemble-Klassifikator kombinieren, um bessere Klassifikationsergebnisse zu erzielen. Die (e)QTL-Analyse beruht auf einer soliden statistischen Theorie, und es gibt aussagekräftige Visualisierungen der Ergebnisse.

    Fazit

    Die hier vorgestellte neue Klasse von Tests und Methoden hat eine einfach anzuwendende Syntax, sodass auch in R unerfahrene Forschende unsere Methoden und Implementierungen nutzen können. Das Paket erzeugt publikationsreife Abbildungen und könnte daher ein wertvolles Werkzeug für die Analyse genomischer Daten sein.

  • Eine neue Publikation

    Eine neue Publikation

    Gestern ist unser Artikel „Subgroup detection in Genotype Data using Invariant Coordinate Selection“ in BMC Bioinformatics erschienen. Auch hier noch einmal danke an alle Mitautorinnen und Mitautoren. Da BMC Bioinformatics eine Open-Access-Zeitschrift ist, gibt es den Artikel hier.