Kategoria: Bioinformatiikka

  • Fluidigm-R-paketti

    Fluidigm-R-paketti

    Fluidigm-R-pakettimme julkaistiin juuri CRANissa. Paketti on tehty helpottamaan Fluidigm-laitteiden genotyyppausaineistojen analysointia. Se tarjoaa joukon työkaluja aineiston käsittelyyn ja analysointiin, mikä helpottaa tutkijoiden työtä. Paketin keskeiset funktiot ovat:

    1. fluidigm2PLINK(...): Muuntaa Fluidigm-aineiston PLINKin käyttämään muotoon ja luo Fluidigm-laitteen CSV-tulosteesta ped/map-tiedostoparin.
    2. estimateErrors(...): Arvioi genotyyppausaineiston virheet.
    3. calculatePairwiseSimilarities(...): Laskee näytteiden väliset parittaiset samankaltaisuudet.
    4. getPairwiseSimilarityLoci(...): Määrittää parittaisen samankaltaisuuden lokukset.
    5. similarityMatrix(...): Luo samankaltaisuusmatriisin.

    Funktiot voi ajaa yksitellen tai kaikki kerralla kätevällä kääreellä fluidigmAnalysisWrapper(...).

  • Lähimpien varianttien löytäminen tiettyihin genomikohtiin

    Lähimpien varianttien löytäminen tiettyihin genomikohtiin

    Genomiikassa pitää usein löytää lähimmät variantit (esim. SNP:t, indelit) joukolle kiinnostavia genomikohtia. Tämä onnistuu erilaisilla bioinformatiikan työkaluilla, kuten bedtoolsilla. Tässä kirjoituksessa käyn vaihe vaiheelta läpi, miten se tehdään.

    Esivaatimukset

    Ennen aloittamista tarvitaan seuraavat tiedostot:

    1. BED-tiedosto kiinnostavista kohdista. Tässä esimerkissä käytämme tiedostoa locations_of_interest.bed
    2. VCF-tiedosto varianteista. Tässä esimerkissä käytämme tiedostoa FinalSetVariants_referenceGenome.vcf

    Vaihe 1: VCF-tiedoston lajittelu

    Ensimmäinen ongelma oli, ettei VCF-tiedosto ollut lajiteltu leksikografisesti. bedtools vaatii syötetiedostot juuri tässä järjestyksessä. VCF-tiedoston voi lajitella seuraavalla komennolla:

    (grep '^#' FinalSetVariants_referenceGenome.vcf; grep -v '^#' FinalSetVariants_referenceGenome.vcf | sort -k1,1 -k2,2n) > sorted_FinalSetVariants_referenceGenome.vcf
    

    Komento erottaa otsakerivit (jotka alkavat merkillä #) datariveistä, lajittelee datarivit ja yhdistää otsakkeen ja lajitellut rivit uuteen tiedostoon sorted_FinalSetVariants_referenceGenome.vcf.

    Vaihe 2: VCF:n muuntaminen BEDiksi ja lähimpien varianttien haku

    Seuraavaksi etsitään kiinnostavia kohtia lähimmät variantit. Oletuksena bedtools closest tulostaa kuitenkin koko VCF-merkinnän, mikä on usein enemmän kuin tarvitaan. Tulosteen rajaamiseksi muunnamme VCF-tiedoston lennossa BED-muotoon ja lisäämme ylimääräiseksi ominaisuudeksi markkerin nimen muodossa chr_bpLocation (näin nimeämme markkerimme). Valitsimella -d saadaan lisäksi etäisyys kohdan ja lähimmän variantin välillä. Komento on tässä:

    awk 'BEGIN {OFS="\t"} {if (!/^#/) {print $1,$2-1,$2,$4"/"$5,"+",$1"_"$2}}' sorted_FinalSetVariants_referenceGenome.vcf | bedtools closest -a locations_of_interest.bed -b stdin -d
    

    Komento lukee VCF-aineiston awkilla, muuntaa sen BED-muotoon ja kirjoittaa tuloksen vakiotulosteeseen. Putki (|) syöttää tämän tulosteen suoraan bedtools closest-komennolle -b-tiedostona. Avainsana stdin kertoo bedtoolsille, että sen pitää lukea vakiosyötteestä.

    Yhteenveto

    Näillä kahdella vaiheella löytyvät tehokkaasti lähimmät variantit joukolle kiinnostavia genomikohtia. Tapa on joustava, ja sen voi sovittaa erilaisiin aineistoihin ja tarpeisiin.

  • Epäonnistunutta R-paketin asennusta ei voinut poistaa

    Tänään kohtasin oudon asian, kun yritin asentaa päivitystä yhteen R-paketeistani. Asensin uusimman version tavalliseen tapaan näin

    library("devtools")
    install_github("fischuu/GenomicTools")

    Asennus kuitenkin epäonnistui, ja kun yritin asentaa uudelleen, sain tämän virheilmoituksen:

    Installing package into ‘/homeappl/home/<user>/R/x86_64-redhat-linux-gnu-library/4.1’
    (as ‘lib’ is unspecified)
    ERROR: failed to lock directory ‘/homeappl/home/<user>/R/x86_64-redhat-linux-gnu-library/4.1’ for modifying
    Try removing ‘/homeappl/home/<user>/R/x86_64-redhat-linux-gnu-library/4.1/00LOCK-GenomicTools’
    Warning message:
    In i.p(...) :
      installation of package ‘/tmp/Rtmp<...>Lv/file3c36<...>34/GenomicTools_0.2.11.tar.gz’ had non-zero exit status

    Menin siis mainittuun hakemistoon poistamaan kansion käsin, ja siellä sain toisen virheen:

    rm: cannot remove '00LOCK-GenomicTools/GenomicTools/libs/.nfs00000001002e2<...>d': Device or resource busy

    Kokeilin sitä sun tätä, mutta mikään ei auttanut kansion poistamisessa; se vain väitti itsepintaisesti, että laite on varattu. Lopulta auttoi vain kansion uudelleennimeäminen näin

    mv 00LOCK-GenomicTools/ 00LOCK-GenomicTools-deleteThis/

    Se roikkuu yhä kansiossa, mutta sain R-paketin asennettua uudelleen. Muutaman päivän päästä katson uudestaan, onko laite yhä varattu vai voinko silloin poistaa sen …

  • Satunnaisotos kokoa k paired-end-FASTQ-tiedostoista

    Kirjoitin tänään bash-skriptin, joka luo satunnaisen osajoukon paired-end-FASTQ-tiedostoparista. Se tarvitsee syötteeksi kahden FASTQ-tiedoston nimet ja otokseen tulevien lukujen määrän.

    Skripti perustuu pääosin tähän blogikirjoitukseen. Koodi on melko karkeaa, ja se voisi olla käyttäjäystävällisempi ja tarjota enemmän vaihtoehtoja, mutta nykyisessä muodossaan se tekee sen, mitä tarvitsen.

    #!/bin/bash
    
    round() {
        printf "%.2f" "$1"
    }
    
    file1=$1
    file2=$2
    sample=$3
    # Input test
     if ! [[ $sample =~ ^-?[0-9]+([.][0-9]+)?$ ]]; then 
    >&2 echo "$sample is not a number"; exit 1; 
    fi
      
    extension1="${file1##*.}"
    extension2="${file2##*.}"
    filename1="${file1%.*}"
    filename2="${file2%.*}"
    
    fn1=$filename1"_"$sample".fastq"
    fn2=$filename2"_"$sample".fastq"
    
    if [ $extension1 == "gz" ]; then
      gunzip $file1;
      file1=$filename1;
      filename1="${file1%.*}"
      fn1=$filename1"_"$sample".fastq"
    fi
    if [ $extension2 == "gz" ]; then
      gunzip $file2;
      file2=$filename2;
      filename2="${file2%.*}"
      fn2=$filename2"_"$sample".fastq"
    fi
    
    lines=$(wc -l < $file1)
    echo $lines
    echo $sample
    
    if (( $(awk 'BEGIN {print ("'$sample'" <= 1)}') )); then
      sample=$(awk 'BEGIN {printf("%.0f", "'$sample'" * "'$lines'")}')
    fi
    
    echo $sample
    
    paste $file1 $file1 | \
    awk '{ printf("%s",$0); n++; if(n%4==0) { printf("\n");} else { printf("\t");} }' | \
    awk -v k=$sample 'BEGIN{srand(systime() + PROCINFO["pid"]); }{ s=x++<k?x- 1:int(rand()*x);
                      if(s<k)R[s]=$0}END{for(i in R)print R[i]}' | \
    awk -F"\t" -v file1=$fn1 -v file2=$fn2 '{print $1"\n"$3"\n"$5"\n"$7 > file1;\
                                             print $2"\n"$4"\n"$6"\n"$8 > file2}'
                                             
    if [ $extension1 == "gz" ]; then
      gzip $fn1;
      gzip $file1;
    fi
    if [ $extension2 == "gz" ]; then
      gzip $fn2;
      gzip $file2;
    fi
    
  • Uuden naudan genomin vertailu

    Uuden naudan genomin vertailu

    Vuodesta 2014 naudan genomitutkimusten standardi on ollut UMD 3.1 -genomi, jonka voi ladata esimerkiksi täältä:


    Muutama päivä sitten julkaistiin kuitenkin uusi kokoonpano, ARS_UCD1.2. Sen voi ladata täältä:

    ftp://ftp.ncbi.nlm.nih.gov/genomes/all/GCA/002/263/795/GCA_002263795.2_ARS-UCD1.2/

    Saadakseni nopean käsityksen vertasin kokoonpanoja ja niiden samankaltaisuutta LAST-ohjelmalla http://last.cbrc.jp/ .

    Ensin loin LAST-tietokannan näin

    lastdb -P0 -uNEAR -R01 $FOLDER/UMD31/UMD31-NEAR $FOLDER/UMD31/UMD3.1_chromosomes.fa
    

    Sitten määritin substituutio- ja aukkofrekvenssit

    last-train -P0 --revsym --matsym --gapsym -E0.05 -C2 $FOLDER/UMD31/UMD31-NEAR $FOLDER/ARS/ARS_UCD12.fna > $FOLDER/UMD-ARS.mat
    

    Koulutuksen jälkeen ajettiin vertailu (tässä Slurm-skriptin rinnakkainen osa)

    FOLDER="/wrk/daniel/References/";
    chr=($(ls $FOLDER/ARS/chr*));
    
    lastal -m50 -E0.05 -C2 -p $FOLDER/UMD-ARS.mat $FOLDER/UMD31/UMD31-NEAR ${chr[$SLURM_ARRAY_TASK_ID]} | last-split -m1 > UMD-ARS-$SLURM_ARRAY_TASK_ID.maf
    

    Koska ajoin vertailun rinnakkain jokaiselle kromosomille, tiedostojen otsakkeet piti poistaa

    cat *.maf > all.maf
    sed '/^#/ d' < all.maf > temp.maf
    head -n 22 all.maf > headerLines
    cat headerLines temp.maf > alignments.maf

    Lopuksi yhdistetyt simple sequence -kohdistukset hylättiin, kohdistukset muunnettiin taulukkomuotoon ja kohdistukset, joiden virhetodennäköisyys oli > 10^-5, hylättiin:

    last-postmask alignments.maf |
    maf-convert -n tab |
    awk -F'=' '$2 <= 1e-5' > alignments.tab

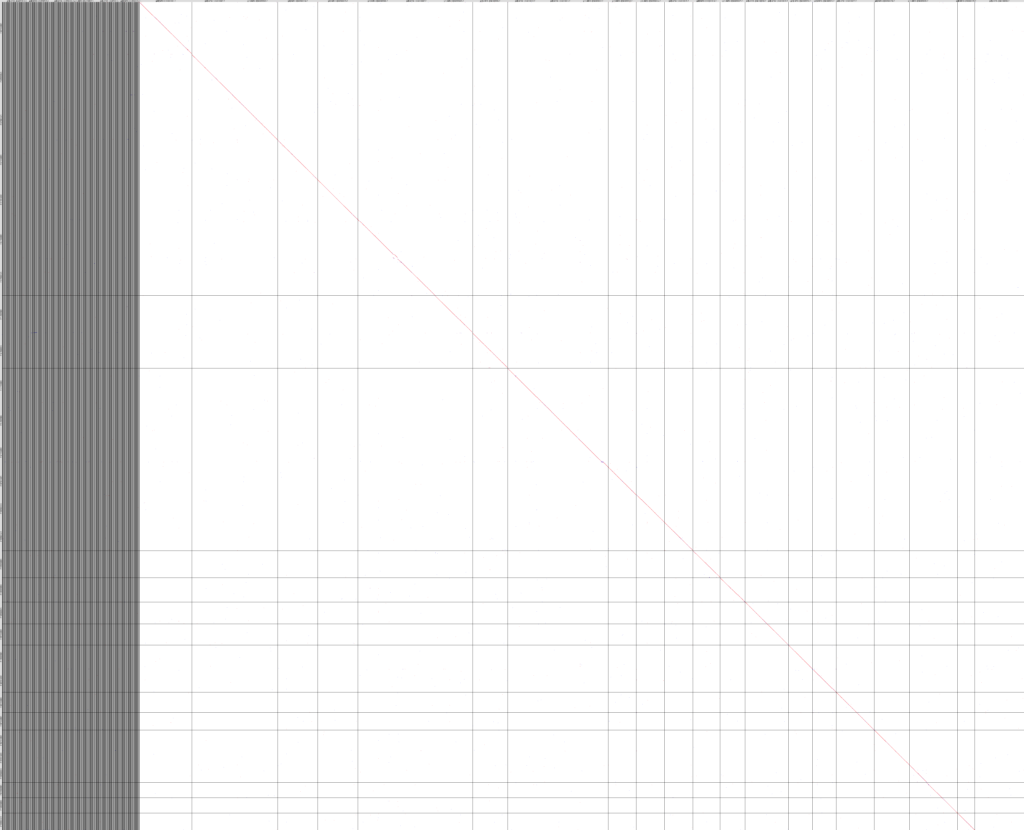
    Ja tästä taulukkotiedostosta tehtiin sitten pistekuvaaja

    last-dotplot -x 4000 -y 4000 alignment.tab alignment.png

    Pistekuvaaja näyttää tältä: genomi vaikuttaa pääosin samalta, mutta joillakin alueilla se on selvästi muuttunut! (Avaa kuva ja zoomaa diagonaaliin nähdäksesi erot)
     

    Vaiheissa seurasin tätä ohjetta: https://github.com/mcfrith/last-genome-alignments